Liaison Education
Tecnologia para ensino superior. A skie reduziu custos de AWS em US$ 1,8 milhão por ano sem sacrificar desempenho ou escalabilidade.
Leia o case de Liaison Education →
O Sage é o motor de otimização de custos da skie para AWS. Ele redimensiona seus recursos, do compute às bases de dados e ao armazenamento, planeja quais compromissos comprar e concilia os dois em uma única passagem, porque mudar um altera a resposta do outro. Depois aplica as mudanças para você, dentro de uma janela de manutenção que você já aprovou.
Eficiência que libera orçamento e tempo de engenharia para o que você vai construir a seguir na AWS. Disponível no AWS Marketplace.
Recomendações viram resultados
A maioria das ferramentas entrega uma lista e deseja boa sorte. Essas listas ficam intocadas por meses e quase nunca é por discordância. Redimensionar uma instância significa pará-la e iniciá-la de novo, e ninguém quer abrir uma janela de mudança apenas para economizar. O Sage elimina esse problema ao vincular a mudança a uma janela que você já executa.
Uma execução de redimensionamento produz a mudança de tipo de instância proposta, com recurso, conta e região anexados.
A mudança vira uma ação rastreada, programada para aplicar no próximo patch do sistema operacional. A indisponibilidade já está prevista, então o redimensionamento não custa nada a mais em risco ou coordenação.
O skie Guardian realiza a mudança durante a janela de patch, junto com a manutenção que você faria de qualquer forma.
O resultado é gravado na recomendação, com data, hora e status. Ações aplicadas, pendentes e canceladas são contabilizadas, e as falhas continuam visíveis em vez de sumirem.
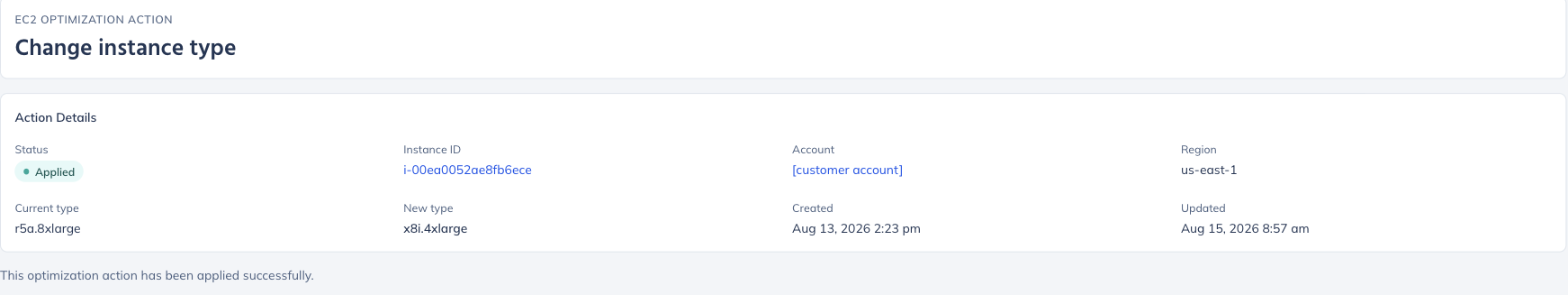
A implementação automatizada já está disponível para EC2, RDS e EBS. Os ambientes onde ela roda incluem instâncias produtivas de SAP S/4HANA e de bancos de dados HANA.
A outra metade é o Guardian, que opera o ambiente no dia a dia e aplica essas mudanças como parte dessa operação. É por isso que as recomendações desta página viram resultados em vez de backlog. Veja como o Guardian opera o ambiente →
Uma resolução, não três
Savings Plans e Reserved Instances são compartilhados entre EC2, ECS e EKS. Otimize qualquer um deles isoladamente e você erra nos outros dois. O Sage resolve os três em uma única execução, de modo que o plano de compromissos reflete o footprint que você realmente terá depois do redimensionamento, e não o de hoje.
Como isso aparece em uma única execução de otimização
| O que a execução faz | Por que importa |
|---|---|
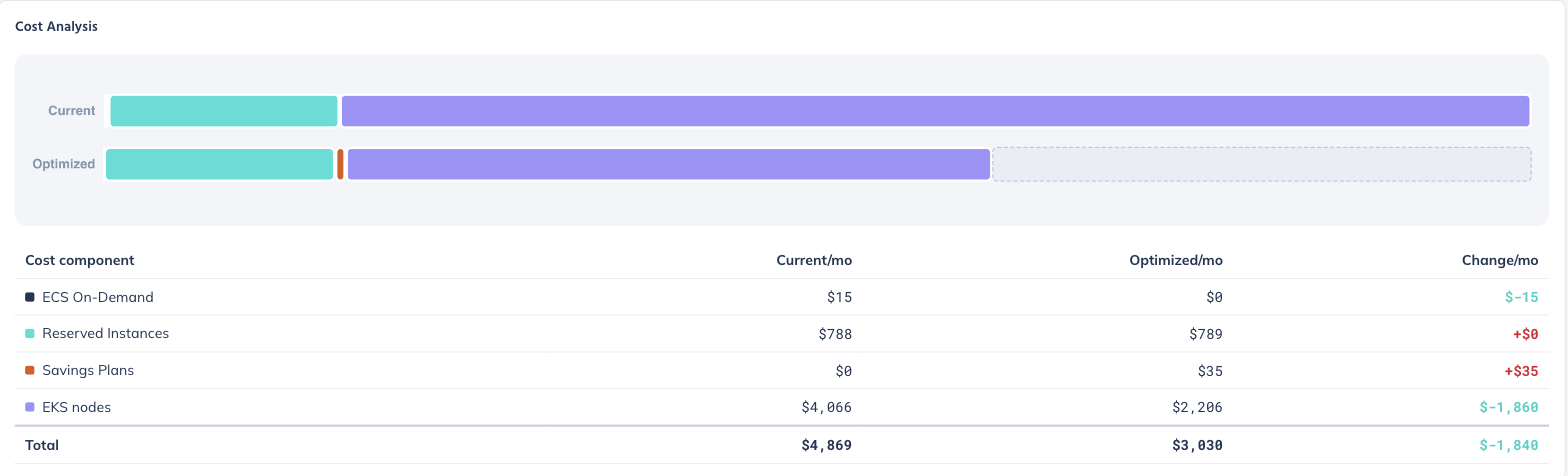
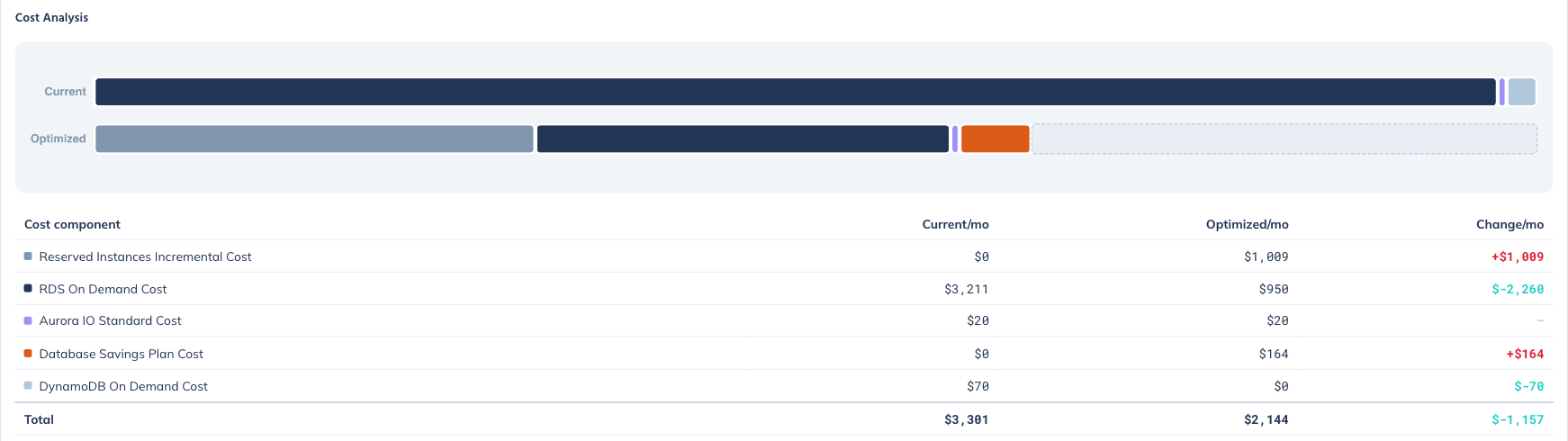
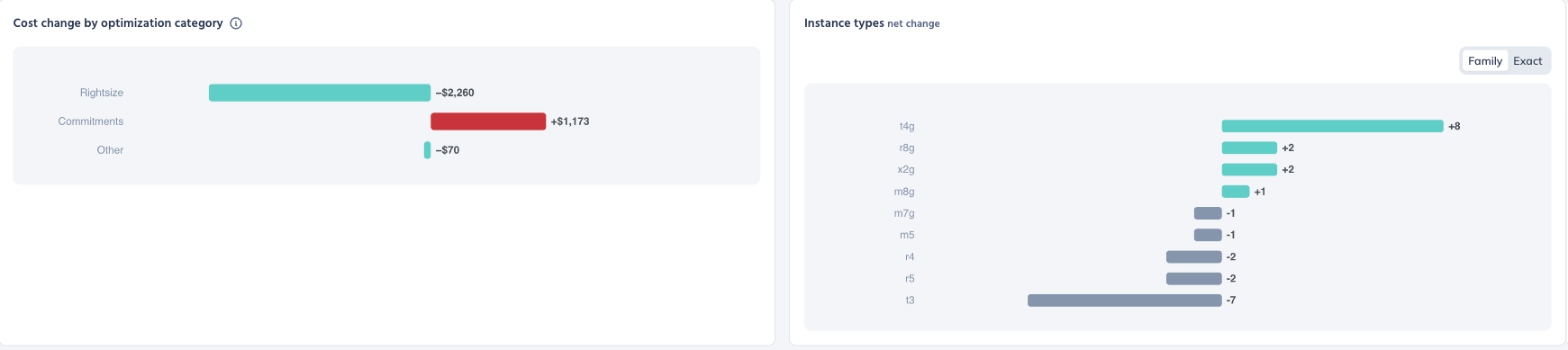
| Reduz o gasto de redimensionamento e aumenta o gasto com compromissos no mesmo plano | Redimensionar muda o formato do seu consumo, então a posição de compromisso correta muda junto. Às vezes o total mais barato significa comprar mais compromisso, não menos. Uma ferramenta que trata os dois separadamente não chega a essa resposta. |
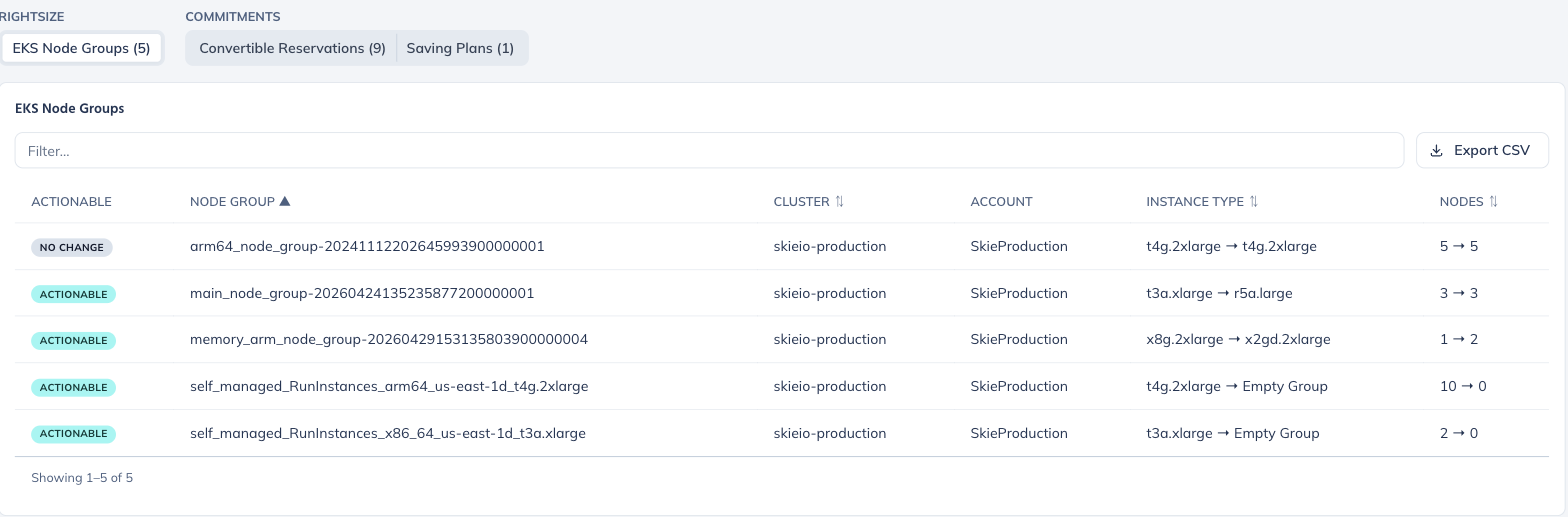
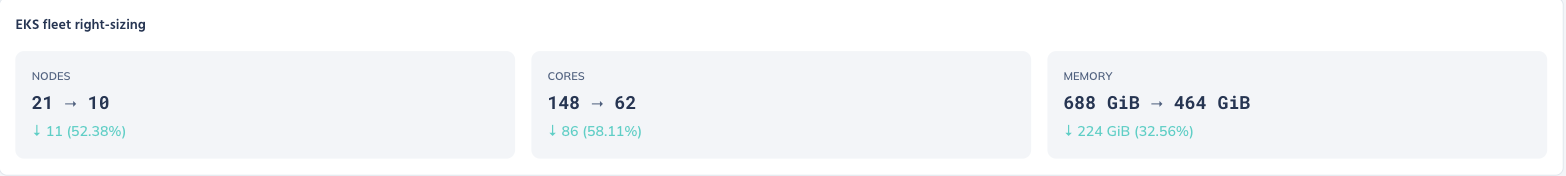
| Aumenta um node group enquanto esvazia outros | Consolidar cargas de trabalho em menos node groups, melhor ajustados, pode significar crescer um deles. O total cai mesmo com uma linha subindo. |
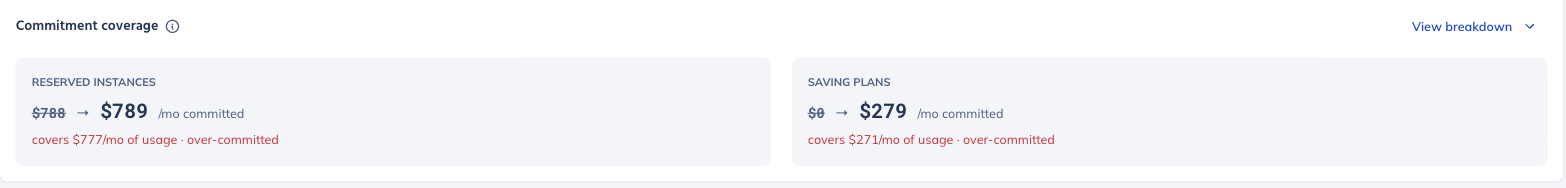
| Sinaliza Reserved Instances e Savings Plans como supercomprometidos | O Sage avisa quando você está comprometido além do consumo que consegue cobrir, conciliando cada compromisso individual com sua utilização mensal medida. É o oposto do incentivo habitual de vender mais compromisso. |
| Trata o EKS como uma frota | Os node groups são dimensionados por nós, núcleos e memória em conjunto, não instância por instância, que é a única forma de as contas fecharem no Kubernetes. |
| Mostra a cobertura de reserva ao lado de cada proposta | Nunca se recomenda um redimensionamento sem mostrar o que cobre a instância atual. Esse é o problema das decisões desconectadas que encarece os custos quando as ferramentas trabalham isoladas. |
Além do compute
Não. Bases de dados e armazenamento são otimizados do mesmo jeito e têm seus próprios instrumentos de compromisso, em vez de pegar emprestado o modelo de compute. Uma execução de banco de dados abrange RDS, Aurora e DynamoDB em uma única passagem, pesando reserved instances e database savings plans junto com as mudanças de tamanho que está propondo ao mesmo tempo.
Duas medidas
Duas medidas, e elas respondem perguntas diferentes. Uma diz o quanto seu compute está bem dimensionado. A outra diz o quanto esse compute está coberto e o que você paga sem usar. As duas são acompanhadas continuamente, então a resposta é um número e não uma opinião.
Percentuais brutos de CPU enganam em uma frota mista, porque uma instância pequena ocupada e uma grande ociosa não pesam igual. O Sage normaliza isso: cada tipo de instância é ponderado pela sua capacidade de compute relativa e a utilização é medida na faixa p90 a p99 em vez da média, para que picos curtos não fiquem escondidos por longos períodos calmos. O resultado é um número único para todo o ambiente.
Redimensionar muda o que você precisa cobrir, então a cobertura tem de ser lida contra o footprint já dimensionado e não contra o original. Junto disso, o Sage acompanha os compromissos que você paga sem usar e quando os atuais vencem.


Entregáveis
Três entregáveis concretos em cada execução, todos exportáveis.
Por recurso: o tipo de instância atual e o proposto, a conta e a região, um score de eficiência antes e depois, e a cobertura de compromisso já associada a ele. Os recursos que devem ficar como estão são marcados assim, em vez de sumirem da lista.
Itens que você pode executar: região, família de instância, plataforma, prazo, opção de pagamento, valor por hora e custo anual, distribuídos entre Instance Savings Plans, Compute Savings Plans e Convertible Reserved Instances.
Quantas instâncias mudariam de família ou de quantidade de vCPU se você executar o plano. O custo de agir é declarado desde o início, não descoberto depois.
Por dentro
O Sage planeja os compromissos como um portfólio em um horizonte de três anos, trimestre a trimestre, usando programação linear inteira mista. É um solver, não um conjunto de regras de bolso, e por isso consegue equilibrar os instrumentos entre si em vez de aplicá-los um a um.
| Etapa | O que acontece |
|---|---|
| Primeiro os compromissos existentes | As Reserved Instances e os Savings Plans que você já tem são modelados como cobertura fixa que vence no próprio calendário. Tudo o que o Sage propõe é incremental sobre o que você já possui. |
| Cobertura trimestre a trimestre | A demanda é coberta ao longo de doze trimestres. Cada trimestre mostra qual fonte cobre o quê e o que fica descoberto a preços sob demanda. |
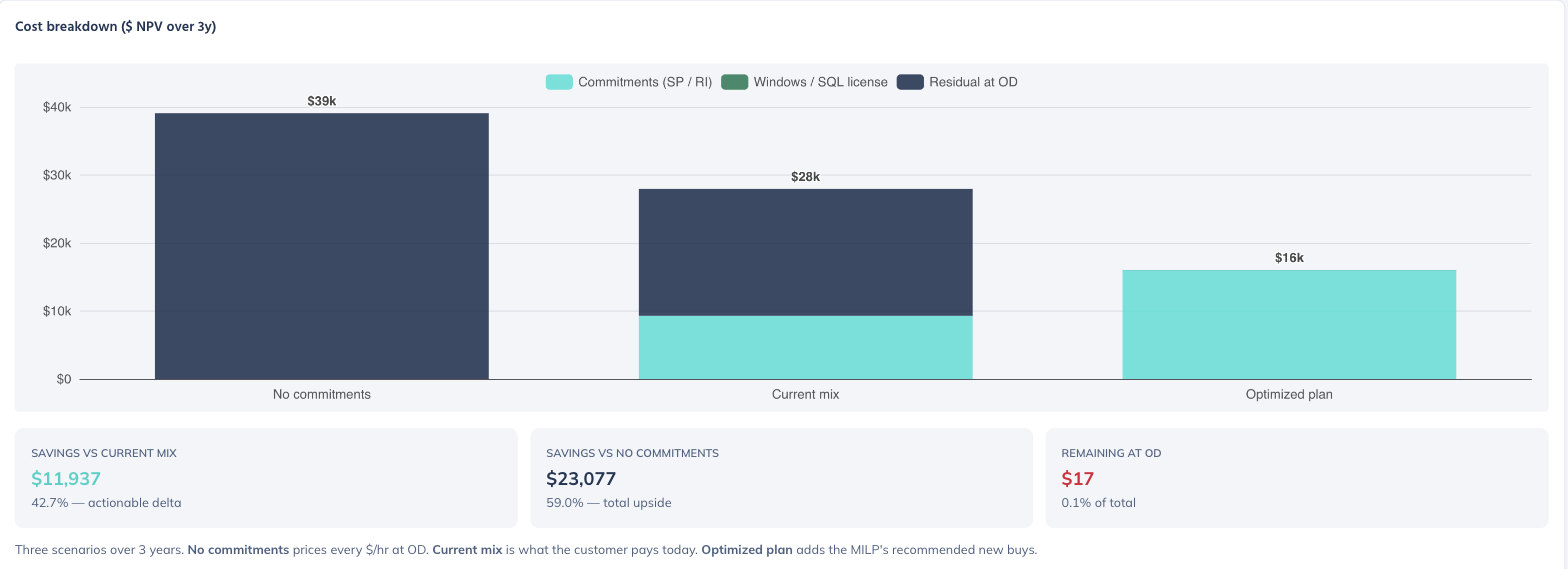
| Três cenários precificados | O que você pagaria sem nenhum compromisso, quanto custa o seu mix atual e quanto custa o plano otimizado. As economias sempre são expressas contra uma linha de base declarada, não como um percentual solto. |
| Execuções versionadas | Cada execução é guardada como um snapshot datado, de modo que os planos podem ser comparados ao longo do tempo e uma decisão pode ser rastreada até o estado em que foi tomada. |
Cobertura de serviços
O Sage analisa e otimiza um conjunto focado de serviços e dá visibilidade sobre um ambiente muito mais amplo. A distinção é deliberada. A otimização profunda é aplicada onde ela se paga.
| Serviço | Profundidade | O que o Sage faz |
|---|---|---|
| EC2 | Otimizado | Redimensionamento e troca de tipo, planejamento de compromissos, implementação automatizada |
| ECS | Otimizado | Incluído na resolução compartilhada de compromissos de compute |
| EKS | Otimizado | Dimensionamento de frota de node groups por nós, núcleos e memória, mais a resolução compartilhada de compromissos |
| RDS | Otimizado | Redimensionamento, planejamento de reserved instances, implementação automatizada |
| EBS | Otimizado | Otimização de tipo e tamanho de volume, implementação automatizada |
| ElastiCache | Otimizado | Redimensionamento e planejamento de nós reservados |
| OpenSearch | Otimizado | Redimensionamento e planejamento de reserved instances |
| S3, EFS, FSx | Visibilidade | Inventário, atribuição de gasto e relatórios |
| DynamoDB, Redshift, Timestream | Visibilidade | Inventário, atribuição de gasto e relatórios |
| Load balancers, NAT gateways, IPs elásticos | Visibilidade | Inventário e atribuição de gasto, com relatório de recursos ociosos |

Depois da otimização
A otimização não é o ponto final. É ela que abre espaço para construir.
Trajetória de um cliente
O consumo de AWS de um cliente caiu de cerca de US$ 44 mil por mês para US$ 29 mil depois da primeira passagem de otimização e depois cresceu para US$ 126 mil conforme ele expandiu na plataforma, sem aumentar a equipe de operações cloud. O crescimento chegou sobre uma base otimizada, e não herdada, então as novas cargas de trabalho já nasceram no tamanho certo.
Veja como isso funciona para equipes em crescimentoConsumo mensal de AWS do ambiente de um único cliente. Valores arredondados. O crescimento do consumo reflete novas cargas de trabalho que o cliente decidiu construir; ele é informado junto com o trabalho de otimização, não atribuído a ele.
Perguntas frequentes
Comece pelos seus próprios números
Uma avaliação gratuita roda sobre o seu consumo real e devolve as mesmas recomendações de redimensionamento, o plano de compromissos e a estimativa de interrupção descritos nesta página.